Narațiunile false sunt deseori livrate sub formă de știri pentru a părea credibile – de aici și denumirea de fake news. O analiză* a narațiunilor false demontate de Veridica de-a lungul timpului arată însă că, dincolo de forma similară, știrile false ies în evidență prin două elemente specifice: accentul pe emoții negative (teamă, furie) și alterarea structurii gramaticale. Existența acestor elemente este însă, deocamdată, insuficientă pentru a putea găsi o formulă clară prin care știrile false să poată fi identificate cu ajutorul Inteligenței Artificiale.
Analiza clasifică textele în patru categorii principale: știri reale, fake news, dezinformare și propagandă de război. Setul de date conține aproximativ 3000 de articole adnotate. Rezultatele validează ideea că manipularea mediatică modernă nu se rezumă doar la informații false; strategiile de manipulare sunt mai complexe, fiind concepute pentru a ocoli filtrul critic al cititorului.
Emoția ca momeală
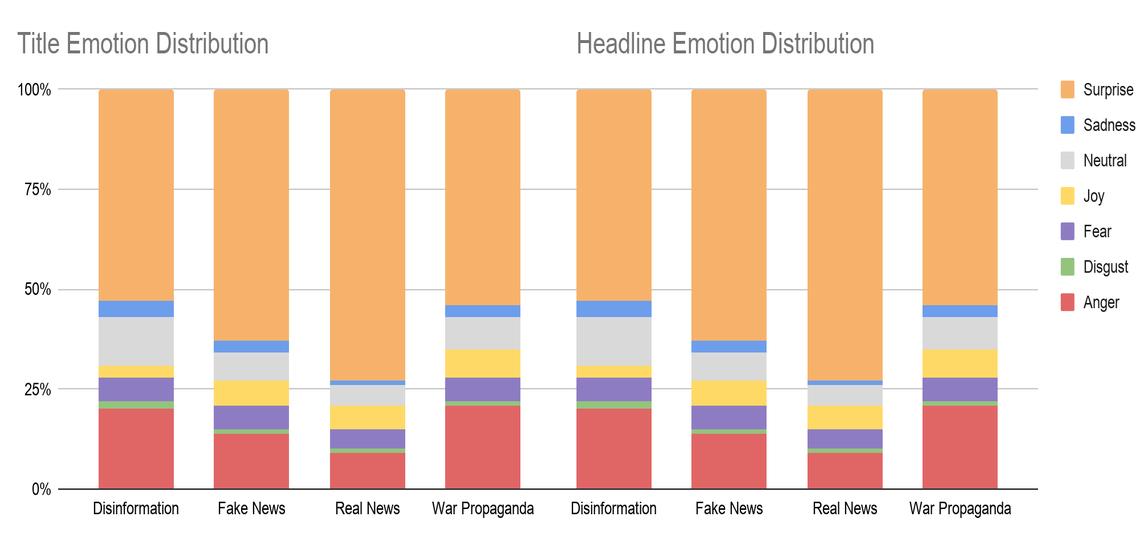
Textele manipulatoare folosesc predominant un ton negativ pentru a capta atenția. Pentru a analiza distribuția emoțiilor în funcție de categoriile de știri, s-a folosit un model automat dedicat clasificării emoțiilor (twitter-xlm-roberta-base-sentiment). În toate știrile, emoția dominantă este surpriza – lucru de așteptat dat fiind că o știre aduce o noutate. La fake news însă au fost detectate furia și frica într-o proporție mult mai ridicată decât la știrile reale, ceea ce sugerează o potențială tactică de manipulare emoțională din partea autorilor.
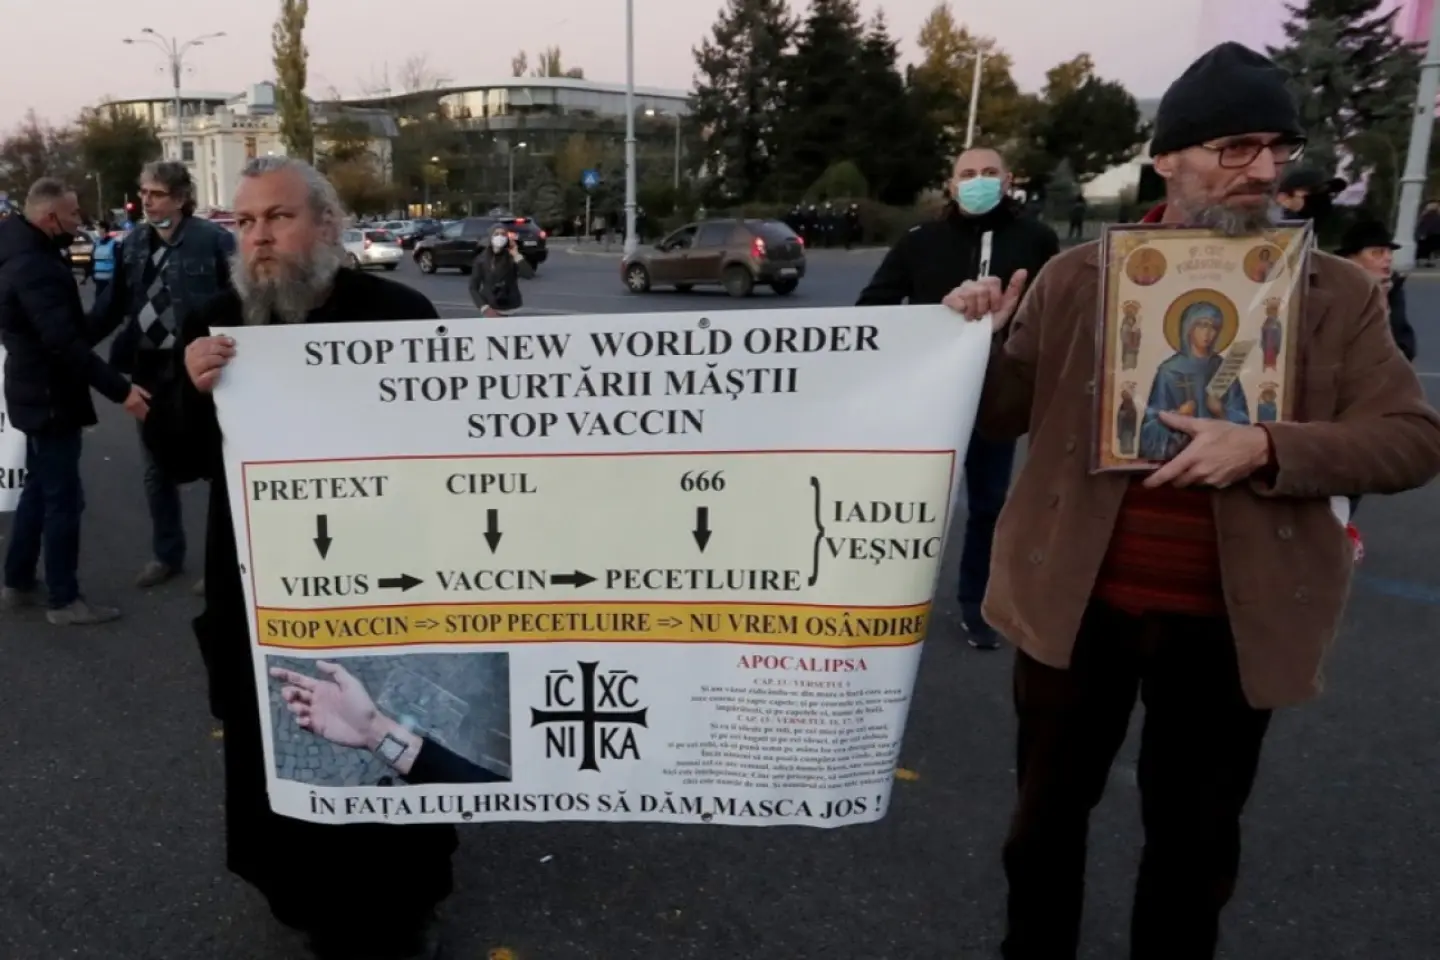
Propoziții scurte, mai ușor de asimilat, diateza pasivă și formulări impersonale de genul „se știe că...”
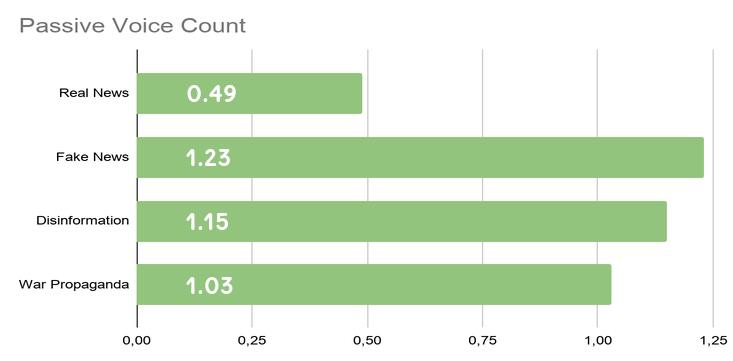
Pe lângă manipularea emoțională, cercetarea arată că știrile false utilizează o structura sintactica diferită față de știrile reale. Discursul manipulator se distinge printr-o utilizare frecventă a diatezei pasive și printr-o densitate crescută a adjectivelor.
Un aspect structural esențial identificat este simplificarea sintaxei. Pentru construirea arborilor sintactici a fost utilizat un algoritm de dependency parsing pentru limba română. Acest algoritm analizează relațiile de dependență între cuvintele unei propoziției. Cu cât există mai puține relații, propozițiile sunt mai simple și arborii sintactici au o adâncime mai mică. Adâncimea reprezintă lungimea celui mai lung lanț de dependențe imbricate, de la rădăcina propoziției până la cel mai îndepărtat cuvânt. Știrile reale folosesc o arhitectură a propoziției mai complexă (o adâncime medie a arborelui sintactic de 5.57), în timp ce articolele de tip fake news folosesc structuri mai scurte și mai simple (adâncime medie de 4.83). Un posibil efect este ca informația să fie asimilată mai rapid, lăsând astfel mai puțin timp pentru evaluarea critică a conținutului.
Pentru analiza părților de vorbire, a fost utilizat un algoritm de Part-Of-Speech Tagging specializat pe limba română. Rezultatele au arătat că în știrile manipulative, structurile la diateza pasivă apar de peste două ori mai des decât în jurnalismul obiectiv. Mai mult, în 94% din aceste cazuri, autorul real al acțiunii este omis în întreaga redactare a articolului.
Folosirea formulărilor impersonale precum „s-a decis” sau „au fost ascunse” permite autorilor să lanseze acuzații autoritare fără a oferi o sursă verificabilă, ascunzând agentul acțiunii.
Poate Inteligența Artificială să detecteze manipularea?
Pentru a sprijini eforturile de monitorizare a spațiului mediatic, cercetarea a evaluat eficiența inteligenței artificiale în detectarea acestor structuri ascunse. Algoritmii clasici bazați pe frecvența cuvintelor au un succes limitat, deoarece pot fi păcăliți ușor de suprapunerile de vocabular (de exemplu, o analiză geopolitică obiectivă poate fi clasificată drept propagandă doar pentru că folosește des cuvinte precum „război” sau „Rusia”).
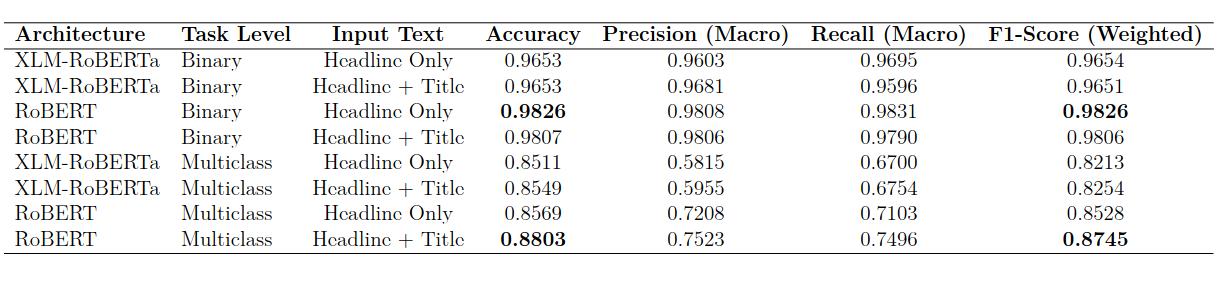
În schimb, modelele automate de tip Transformer, antrenate specific pe limba română (precum RoBERT), au reușit să identifice aceste tipare complexe, atingând o acuratețe de peste 98% în separarea știrilor legitime de cele manipulatoare la nivel binar.
Limitele tehnologiei: Când AI-ul penalizează jurnalismul de opinie
Deși rezultatele sunt promițătoare, sistemele automate au vulnerabilități notabile. Una dintre cele mai frecvente erori este incapacitatea modelelor de a face distincția între dezinformarea reală și jurnalismul de opinie asumat.
Exemplu de clasificare eronată (Fals Pozitiv):
Un articol de opinie care folosește retorică subiectivă a fost clasificat de modelul AI drept manipulare cu o certitudine de 99.7%. Modelul a recunoscut tiparul discursiv polarizant (apelul la emoție, întrebările retorice), dar nu a putut înțelege genul jurnalistic, penalizând subiectivitatea autorului ca fiind intenție de dezinformare.
Modelele mari de limbaj (LLM-uri comerciale) suferă de efectul de „halucinare” din cauza limitării cunoștințelor la momentul antrenamentului, justificând uneori clasificări eronate prin invocarea unor realități politice neactualizate. De asemenea, modelele pot rata identificarea manipulării atunci când dezinformarea este camuflată perfect sub o sintaxă instituțională și un limbaj procedural aparent obiectiv.
Notă: analiza stă la baza tezei de masterat în domeniul procesării de limbaj natural „Media Manipulation Detection on Novel Romanian Dataset”, susținută în cadrul Facultății de Matematică și Informatică a Universității București.